Infrastructura hibridă AWS EKS + ECS Fargate pentru o aplicație full-stack

Dată proiect:
2 februarie 2026

Proiectul implementează o infrastructură hibridă pe AWS pentru Contapics, o aplicație full-stack (Vue.js, Spring Boot, serviciu OCR, PostgreSQL): workload-urile aplicației rulează în EKS, iar stiva de monitorizare Prometheus–Grafana este izolată pe ECS Fargate. Infrastructura este definită sub formă de cod prin Terraform, Helm și Ansible, iar livrarea este automatizată printr-un pipeline CI/CD cu aprobare manuală și rollback automat.

Proiect realizat de
Picture of Florin Zamfir
Florin Zamfir
În cadrul programului de studiu:
1

Înțelegem cum funcționează aplicația

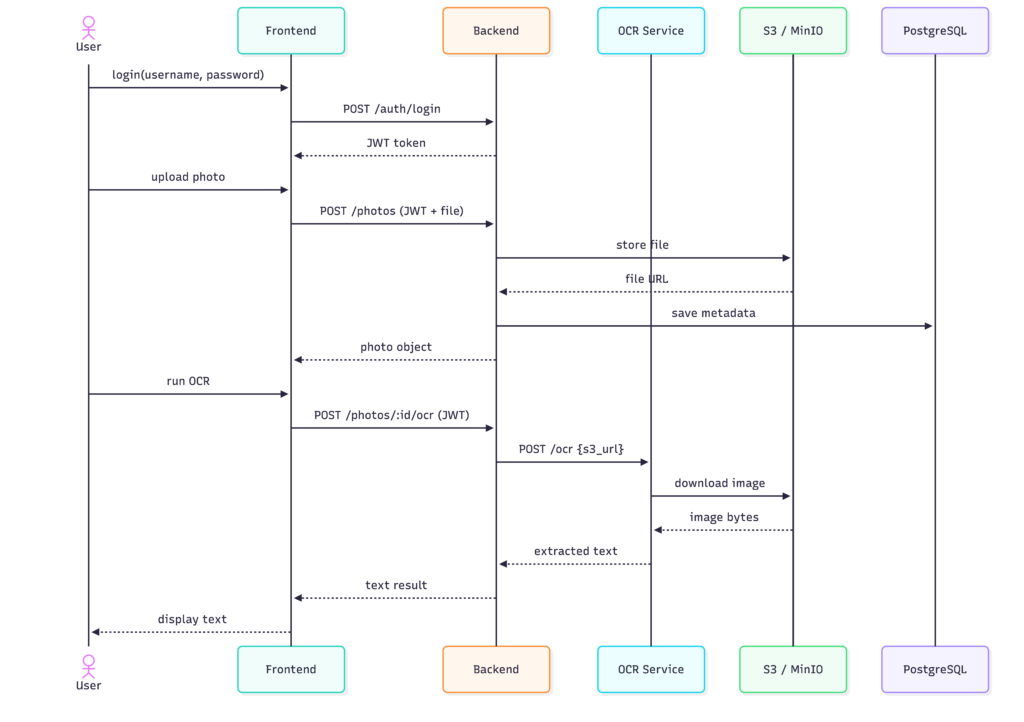
Aplicația Contapics este compusă din patru servicii distincte: un frontend Vue.js, un backend Spring Boot cu REST API și autentificare JWT, un serviciu OCR bazat pe Flask și Tesseract, și o bază de date PostgreSQL. Stocarea fișierelor procesate de serviciul OCR este externalizată în S3/MinIO, separând responsabilitatea persistenței binare de cea relațională. Rezultatul acestui pas este o diagramă de secvență care clarifică fluxurile de date și comunicația între componente.
2

Identificăm infrastructura de calcul

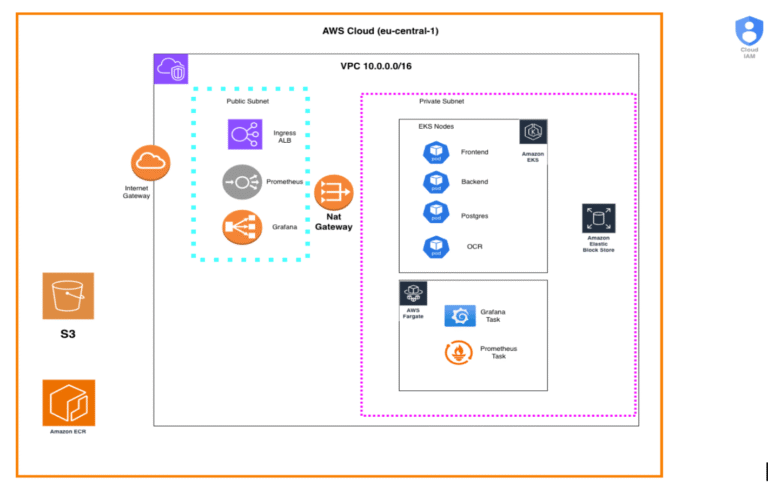
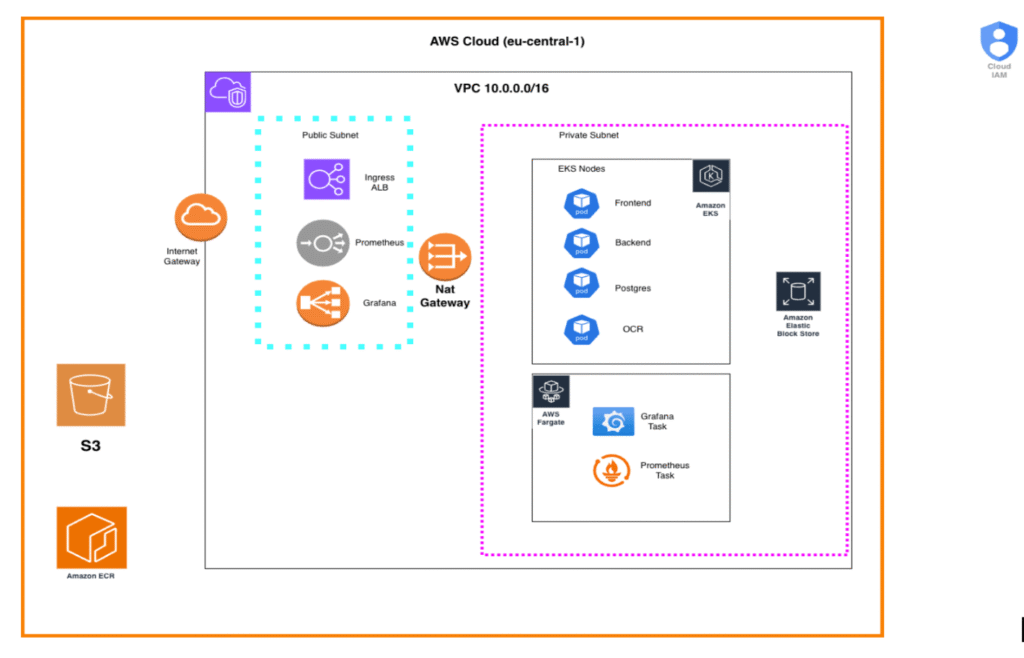
Platforma de deployment aleasă este AWS, într-un VPC dedicat (10.0.0.0/16) în regiunea eu-central-1. Workload-urile aplicației — Frontend, Backend, PostgreSQL și OCR — rulează ca pod-uri în EKS (Private Subnet), în timp ce stiva de monitorizare (Prometheus și Grafana) este izolată pe AWS ECS Fargate pentru a nu concura pe resursele nodului t3.small dedicat aplicației. Accesul extern este asigurat prin Ingress ALB, imaginile Docker sunt stocate în Amazon ECR, datele persistente în Amazon EBS, iar fișierele procesate prin OCR în S3.
3

Facem un deploy simplu

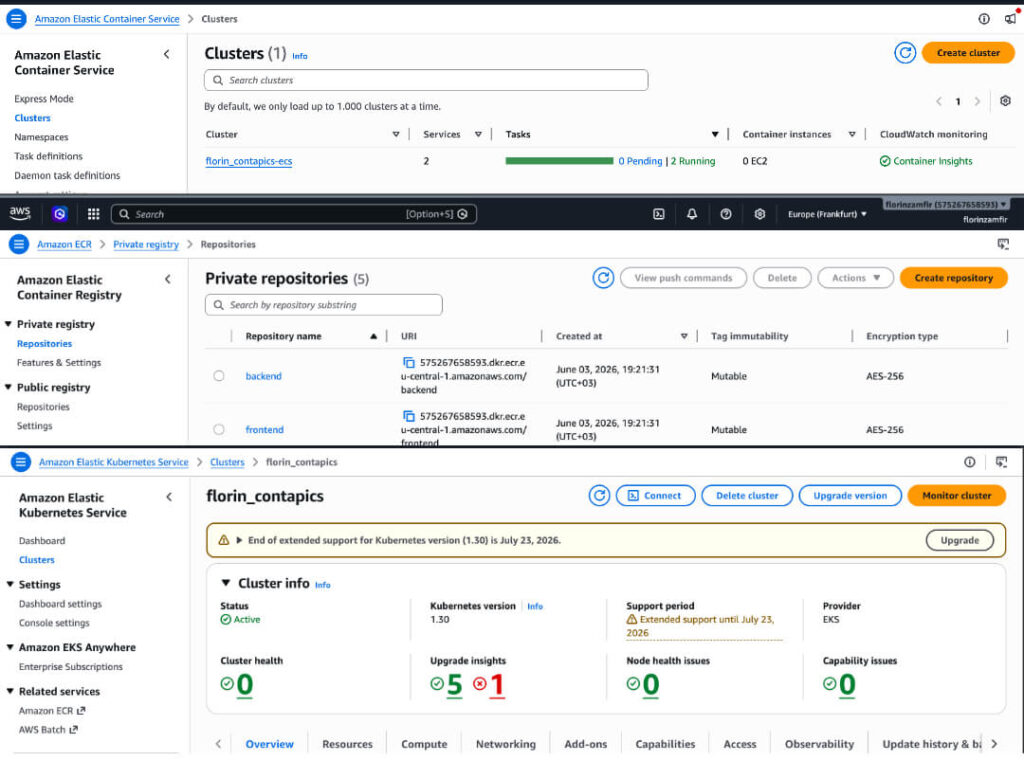
Înainte de automatizarea completă, infrastructura este provizionată și validată manual pentru a confirma că toate componentele cloud sunt configurate corect. Se verifică că clusterul EKS `florin_contapics` este activ și funcțional, că repository-urile ECR pentru backend și frontend sunt create, și că serviciile ECS Fargate pentru monitorizare rulează cu statusul „Running”. Acest pas de smoke-test reduce riscul de a construi automatizări pe o fundație cu erori de configurare nedetectate.
4

Testăm aplicația

După primul deployment funcțional, aplicația este testată end-to-end pentru a valida că toate fluxurile principale — autentificare JWT, management utilizatori și companii, upload și procesare OCR — funcționează corect în mediul cloud. Testarea include astfel verificarea conectivității între servicii, corectitudinea rutelor Ingress și funcționarea IRSA pentru accesul la S3 din pod-urile de backend și OCR, oferind confirmarea că aplicația este accesibilă public și operațională la URL-ul generat de ALB.
5

Înțelegem și optimizăm costurile

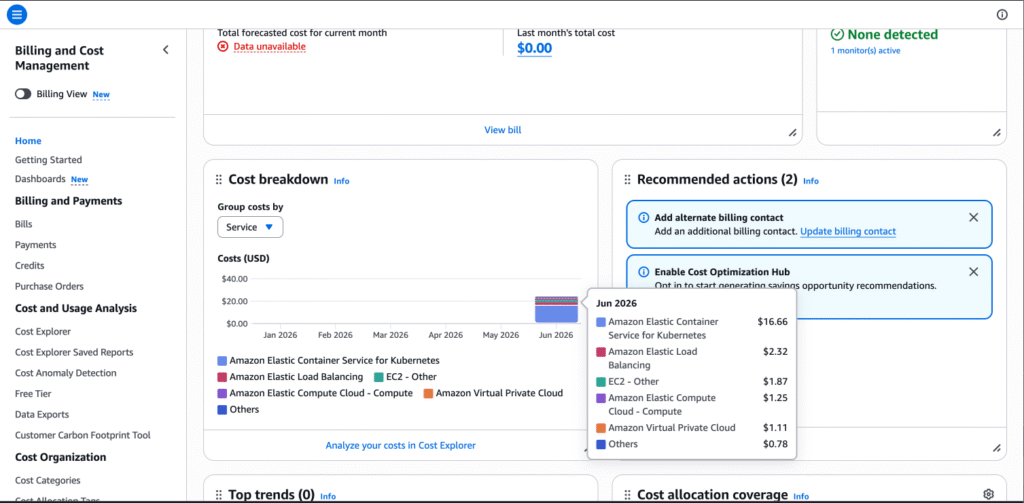
Consumul real de resurse AWS este monitorizat prin AWS Cost Explorer, defalcat pe servicii: EKS domină bugetul, urmat de ALB, EC2 și VPC, cu un total lunar redus datorită utilizării parțiale și limitelor Free Tier. Arhitectura hibridă EKS + ECS Fargate separă monitorizarea de workload-urile aplicației, evitând supraîncărcarea singurului nod t3.small al clusterului și lăsând resursele disponibile pentru workload-urile de business. Cost Optimization Hub semnalează oportunități suplimentare, iar configurația `single_nat_gateway = true` reduce cheltuielile de rețea pentru medii non-producție.
6

Introducem Infrastructure as Code

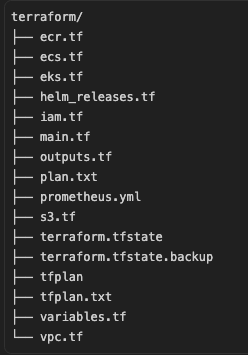
Întreaga infrastructură AWS este codificată în Terraform, organizat în module specializate: `vpc.tf`, `eks.tf`, `ecs.tf`, `ecr.tf`, `s3.tf`, `iam.tf` și `helm_releases.tf` pentru deployment-ul aplicației direct din Terraform. Valorile injectate în Helm sunt extrase dinamic din outputs-urile modulelor de infrastructură — URL-urile ECR, ARN-urile rolurilor IAM, numele bucket-ului S3 — eliminând orice configurare manuală. Ansible orchestrează pașii auxiliari prin două playbook-uri: `cluster_setup.yml` pentru instalarea cert-manager și AWS Load Balancer Controller, și `push_images.yml` pentru build-ul și push-ul imaginilor Docker în ECR.
7

Monitorizare și observabilitate

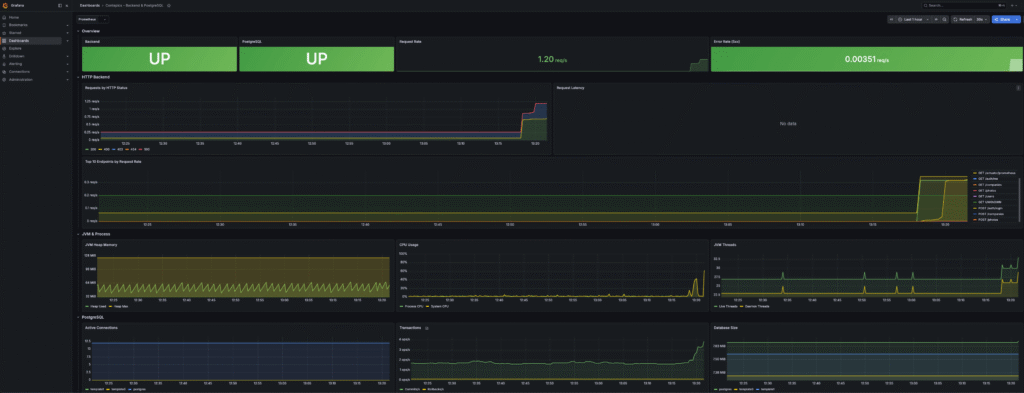
Observabilitatea sistemului este asigurată prin Prometheus și Grafana rulate pe AWS ECS Fargate, izolate de clusterul EKS, cu o imagine Docker customizată pentru Prometheus care rezolvă la runtime adresele dinamice ale nodurilor EKS. Backend-ul expune metrici JVM, HTTP și de business prin Spring Boot Actuator la `/actuator/prometheus`, iar Postgres Exporter furnizează statistici despre conexiuni active, tranzacții și dimensiunea bazei de date, toate vizibile în dashboard-urile Grafana. Dashboard-urile confirmă în timp real starea serviciilor (Backend UP, PostgreSQL UP) și permit identificarea degradărilor prin request rate, latență și error rate vizualizate pe serii de timp.
8

CI/CD Pipeline

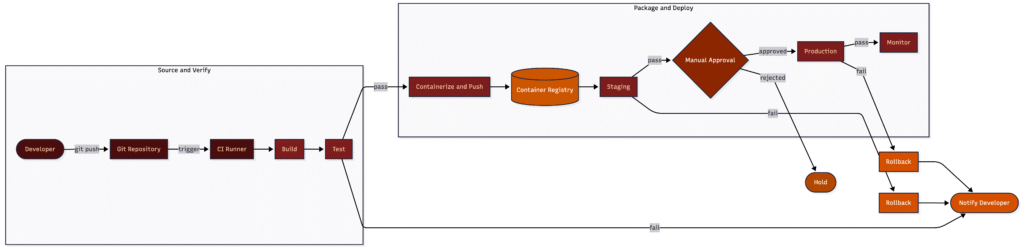
Procesul de livrare este formalizat ca un pipeline cu două faze principale: „Source and Verify” (build și test automat declanșat la git push) și „Package and Deploy” (containerizare, push în Container Registry, deployment în Staging). Înainte de promovarea în producție, pipeline-ul include o etapă de aprobare manuală care oferă control explicit al release-urilor și separă responsabilitatea între echipele de development și operations. În cazul unui eșec în producție sau al respingerii aprobării, pipeline-ul declanșează automat rollback și notifică dezvoltatorul, minimizând MTTR-ul și impactul asupra utilizatorilor.

Descoperă proiecte similare